Définir l'observation et la décision
Un score modèle, une fraction de vote et une probabilité étalonnée sont des quantités différentes. Un score élevé peut encore être faux dans des conditions inconnues. Les cartes de confiance doivent donc indiquer ce que représente le nombre et comment sa fiabilité a été évaluée.
Pour les couches de probabilité et d'incertitude du modèle, commencez par une question précise. Indiquer la décision et la quantité avant de comparer les paramètres du logiciel. Déterminer qui utilisera le résultat, les unités géographiques qu'ils reconnaissent et les éléments probants qui modifieraient une inspection ou une analyse. Écrire l'état de la cible et des explications alternatives plausibles. Cela permet de juger si la méthode d'observation réelle peut répondre à la question. Une carte de finesse n'est pas suffisante lorsque la sortie représente un proxy avec une signification différente. Conserver un registre des hypothèses courtes afin que les évaluateurs plus tard puissent distinguer les intrants mesurés, les choix de modèles et l'interprétation.
Correspond au support des données à la méthode
La base de mesure des niveaux de probabilité et d'incertitude du modèle est importante tout au long de l'interprétation. Un modèle satellite apprend une relation entre des intrants définis et des cibles de référence dans des conditions échantillonnées. Il ne crée pas d'informations absentes du capteur ou corrige automatiquement les étiquettes incohérentes. Définir les significations de classe ou les unités cibles continues avant de sélectionner un algorithme. Correspondez à la référence de formation au temps d'image et au support spatial, et enregistrez l'incertitude ou le désaccord dans les étiquettes. Déterminer la région de déploiement, la saison et les conditions d'acquisition prévues. Ces choix déterminent quelles généralisations devraient être testées et empêchent qu'un score de développement impressionnant ne soit confondu avec des preuves que le modèle est prêt à un autre contexte opérationnel.
Préparer une analyse traçable
Évaluer la fiabilité des scores à l'aide de données de référence indépendantes et d'une méthode d'étalonnage appropriée au besoin. Gardez l'ajustement d'étalonnage séparé de l'évaluation finale. Préserver un drapeau hors domaine ou non supporté de données avec probabilité.
La préparation des couches de probabilité et d'incertitude du modèle devrait préserver les éléments suivants. Préparer un manifeste de prédicteur reproductible avec les dates de source, l'ordre de bande, les unités, les masques et le prétraitement. L'évaluation séparée avant la sélection des caractéristiques, l'échelle, le réglage ou l'extraction de patch peut fuiter l'information dans toute la division. Utiliser des partitions géographiques ou temporelles appropriées pour le déploiement, et comparer une simple base de référence. Préserver les paramètres du modèle, les semences aléatoires, le cas échéant, et les versions logicielles. Tester les données manquantes et les conditions d'image difficiles. Une formation qui converge ou qui se termine n'est qu'une étape technique; son résultat doit encore être évalué en fonction de preuves indépendantes et des conséquences de la décision envisagée.
Essai d'un pilote représentatif
Un projet pilote de niveaux de probabilité et d'incertitude pour le modèle devrait traiter de la réception réelle flux de travail. Commencez par un pilote représentatif qui contient des conditions ordinaires et des exceptions difficiles. Inclure les limites pertinentes, les surfaces mixtes, les observations manquantes et les emplacements de référence connus. Enregistrez quelques exemples numériques vérifiés manuellement en même temps que les métadonnées sources. Comparez le résultat avec un lecteur indépendant ou un calcul lorsque cela est pratique. Le pilote doit tester le parcours complet de la sélection de la source à l'exportation, car une formule correcte peut encore être minée par des unités erronées, un ordre de bande ou une manipulation de validité. Une fois que le pilote a été compris, conservez-le comme référence pour les révisions ultérieures.
Reconnaître les risques d'interprétation spécifiques à un sujet donné
Un modèle confiant peut échouer systématiquement après un capteur ou un changement saisonnier. L'étalonnage dans un régime de prévalence peut ne pas se transférer. L'affichage de nombreuses décimales crée une précision sans preuve si la fiabilité n'a pas été mesurée.
L'examen des niveaux de probabilité et d'incertitude du modèle devrait se poursuivre après la fin du calcul. Évaluer plus d'un score global. Signaler la confusion propre à une classe pour la classification ou les biais et les modèles d'erreur pour la régression, avec le soutien de l'échantillon et la portée géographique ou temporelle. Évaluer délibérément des cibles difficiles et rares. Conserver les scores du modèle distincts des probabilités étalonnées et conserver un drapeau du domaine non supporté, le cas échéant. Inspecter les erreurs représentatives et comparer le fardeau de l'examen opérationnel créé par les fausses alarmes. Lors du transfert ou de la mise à jour d'un modèle, évaluer le candidat sur des données intactes et conserver la version précédente. La surveillance demeure fiable seulement lorsque l'on examine les changements d'intrants et de résultats, plutôt que de supposer que le rendement initial persiste indéfiniment.
Travail à travers un exemple illustratif
Imaginez un classificateur illustratif qui attribue 0.95 à de nombreux pixels, mais seulement 70% des exemples indépendants notés de la même façon sont corrects. La note est trop fiable dans ce contexte d'évaluation.
L'exemple de raisonnement pour les couches de probabilité et d'incertitude du modèle a un rôle délibérément limité. L'exemple de cet article est illustratif et n'est pas un résultat du projet, une demande d'exactitude ou une garantie de performance. Remplacer ses hypothèses par des valeurs mesurées du projet avant d'utiliser le raisonnement de façon opérationnelle. Conserver les unités, les dates d'observation et le dénominateur pertinent visible. Si un masque, une référence ou un paramètre de rechange raisonnable modifie la décision, signalez cette sensibilité et obtenez de meilleures preuves lorsque cela est pratique. Les décimales supplémentaires ne résolvent pas l'incertitude dans ce qui a été observé. Conserver les cas non résolus explicitement au lieu de sélectionner le paramètre qui produit le plus persuasif narratif.
Évaluer à l'aide de preuves indépendantes
Utiliser des résumés de fiabilité, des vérifications spécifiques à chaque classe et des tests indépendants de transfert. Examiner les régions difficiles et les conditions d'entrée manquantes. Comparer les décisions de seuil en utilisant à la fois des erreurs et des conséquences opérationnelles.
L’évaluation indépendante doit représenter la population et les conditions d’utilisation du résultat. Séparez les observations servant au choix des paramètres ou à l’apprentissage du modèle de celles utilisées pour évaluer ses performances. Incluez des cas difficiles ne correspondant pas à la cible, ainsi que des cibles évidentes, et conservez les informations sur les zones sans données ou non observables. Faites correspondre au mieux la date et le support spatial de la référence. En cas de désaccord, examinez l’analyse et les preuves de référence. Celles-ci peuvent aussi être incertaines : les forcer à correspondre à la carte ne constitue pas une correction valable.
Signaler l'incertitude à l'échelle utile
Pour les couches de probabilité et d'incertitude du modèle, un résultat doit conserver sa portée démontrée. Examiner l'incertitude à l'échelle de la décision prévue. L'espacement des pixels, le support efficace des capteurs, les quartiers de traitement et les unités de gestion peuvent différer considérablement. De nombreux pixels rééchantillonnés ne créent pas beaucoup d'observations indépendantes. Pour un résumé de zone, conservez la couverture valide et les exclusions; pour une caractéristique candidate, conservez l'assurance de détection et la date de la source. Séparer les effets systématiques des variations locales lorsque les preuves le permettent. Une petite erreur moyenne n'exclut pas un biais corrélatif dans une catégorie rare, un matériau particulier ou une région sous-représentée. Indiquer la portée de l'évaluation.
Fournir des données utiles GIS et des analyses
Définition des points d'exportation, provenance de l'étalonnage et limites d'applicabilité. ITSensing l'analyse devrait distinguer la classe prévue, la probabilité et la qualité d'observation plutôt que de les fusionner en une seule étiquette de certitude.
La transmission des niveaux de probabilité et d'incertitude du modèle devrait rester compréhensible en dehors de l'environnement auteur. Fournir un aperçu accessible, ainsi que les données géospatiales pertinentes et un dictionnaire de données concis. Conserver des identifiants stables, des références sources, des dates d'observation, une version de traitement, des champs de référence de coordonnées et de qualité. Expliquer les zones inconnues et la prochaine vérification utile dans un registre d'exception. Demandez à l'analyste qui reçoit un échantillon de trouver un échantillon, d'en identifier les preuves et d'interpréter ses limites. Cette revue pratique peut révéler un contexte manquant qu'un contrôle d'intégrité de fichier ne peut pas détecter. Préservez la raison des révisions afin qu'un changement ultérieur puisse être attribué à de nouvelles observations ou à une méthode modifiée.
Évaluer le ITSensing flux de travail avec des entrées réelles
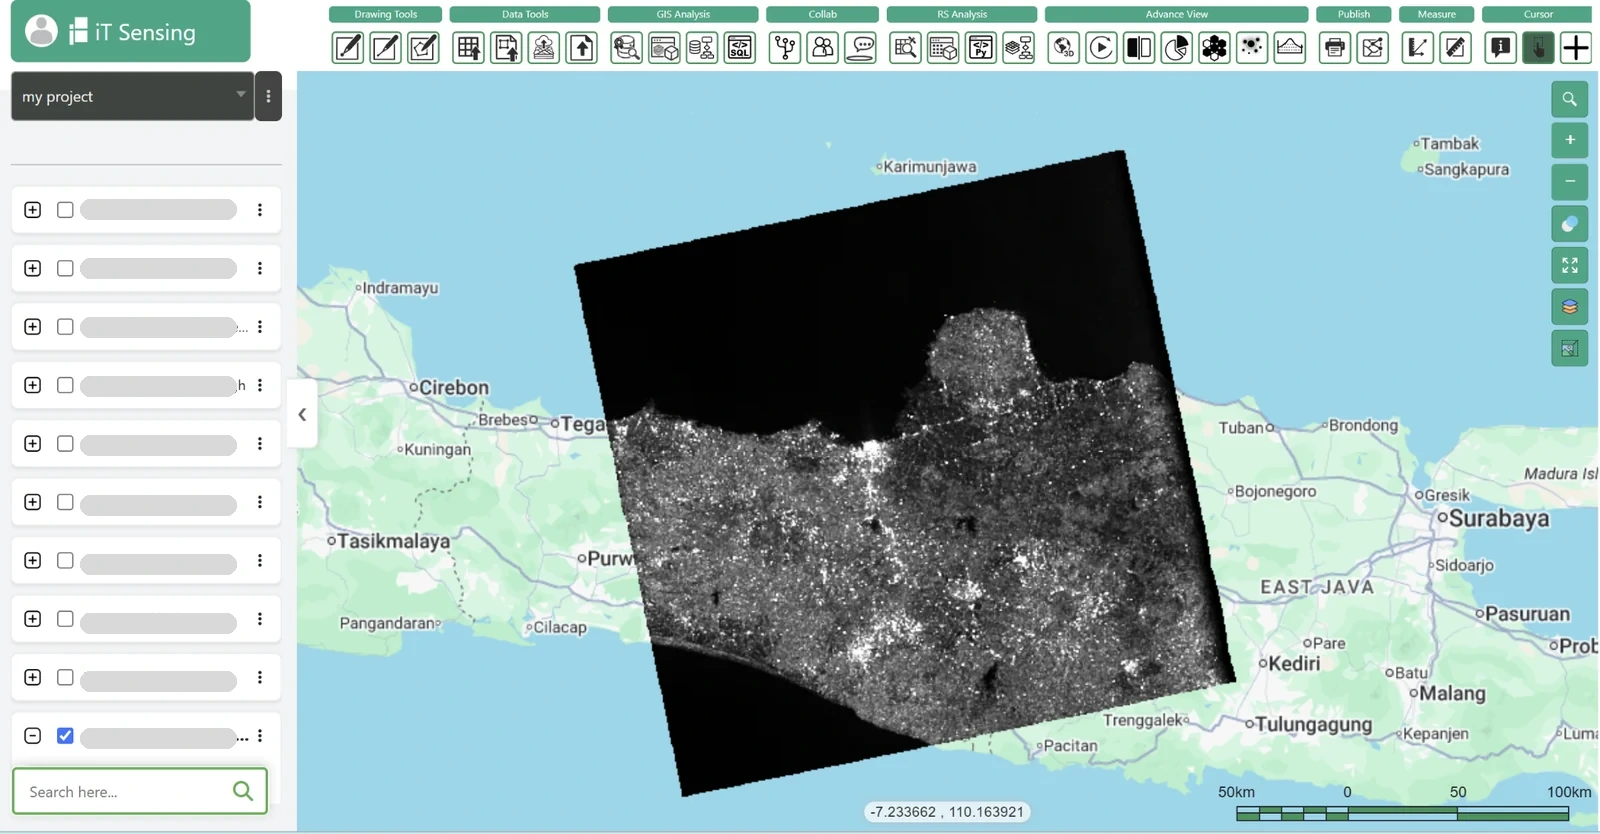
Pour évaluer le logiciel Cloud télédétection pour les couches de probabilité et d'incertitude du modèle, utilisez un pilote documenté. Utilisez la comparaison de produit pour tester un flux de travail complet avec des données représentatives. ITSensing présente un espace de travail en nuage pour la découverte par satellite, l'analyse raster et spectrale, apprentissage automatique, GeoAI, le modèle de construction et le travail basé sur Python. Ces capacités générales n'établissent pas que chaque méthode spécialisée décrite ici est un bouton natif ou que chaque service externe se connecte directement. Vérifiez l'outil documenté réel, l'entrée prise en charge et le chemin d'exportation. Conserver les preuves du pilote et la validation indépendante avant de choisir un flux de travail. Un lien produit est un point d'entrée pour l'évaluation, tandis que l'interprétation scientifique reste liée aux données et à la méthode.