Die Beobachtung und Entscheidung definieren
Ein zufälliger Wald kombiniert Entscheidungsbäume, die an Ausbildungsbeispielen angebracht sind. Es kann nichtlineare Beziehungen zwischen Satelliten-Funktionen modellieren, aber seine Vorhersagen reflektieren die Etiketten und abgetasteten Bedingungen. Ein flexibler Klassifikator verallgemeinert nicht automatisch in einen anderen Bereich.
Für zufällige Landbedeckung Vorhersagen, beginnen Sie mit einer genauen Frage. Geben Sie die Entscheidung und die Menge vor dem Vergleich von Softwareeinstellungen. Identifizieren Sie, wer das Ergebnis verwenden wird, die geographischen Einheiten, die sie erkennen und welche Beweise eine Inspektion oder Analyse ändern würden. Schreiben Sie die Zielbedingung und plausible alternative Erklärungen. Damit kann beurteilt werden, ob die tatsächliche Beobachtung der Methode die Frage beantworten kann. Eine fein aussehende Karte reicht nicht aus, wenn die Ausgabe einen Proxy mit einer anderen Bedeutung darstellt. Halten Sie ein kurzes Annahmen-Register, so dass spätere Prüfer Messeingänge, Modellwahlen und Interpretation unterscheiden können.
Passende Datenunterstützung für das Verfahren
Die Messgrundlage für zufällige, Landbedeckung Vorhersagen ist bei der Interpretation wichtig. Ein Satellitenmodell lernt eine Beziehung zwischen definierten Eingaben und Referenzzielen unter abgetasteten Bedingungen. Es erzeugt keine Informationen, die vom Sensor absagt oder korrekte inkonsistente Etiketten automatisch. Definieren Sie Klassenbedeutungen oder kontinuierliche Zieleinheiten, bevor Sie einen Algorithmus auswählen. Passen Sie den Trainingsbezug auf Bildzeit und räumliche Unterstützung, und erfassen Sie Unsicherheit oder Unstimmigkeit in den Etiketten. Identifizierung der vorgesehenen Einsatzregion, Saison und Akquisitionsbedingungen. Diese Entscheidungen bestimmen, welche Verallgemeinerung getestet werden soll und verhindern, dass ein beeindruckendes Entwicklungsergebnis auf Beweise verwechselt wird, dass das Modell für eine andere operative Einstellung bereit ist.
Bereiten Sie eine nachvollziehbare Analyse vor
Klassen definieren, konsistente Vorhersagen vorbereiten und die Ausbildung von der Bewertung geografisch trennen. Tune mit Trainingspartitionen und vergleichen Sie eine einfache Basislinie. Behalten Sie zufälliges Saatgut, Merkmalsdefinitionen und Modellparameter für Reproduzierbarkeit.
Die Vorbereitung auf die zufälligesten Landbedeckung Vorhersagen sollte folgende Beweise erhalten. Bereiten Sie ein reproduzierbares Vorhersage-Erscheinungs-Erscheinnis mit Quelldaten, Bandauftrag, Einheiten, Masken und Vorverarbeitung vor. Separate Auswertung vor Auswahl, Skalierung, Tuning oder Patch Extraktion können Informationen über die Spaltung. Verwenden Sie geografische oder zeitliche Partitionen, die der Bereitstellung angemessen sind, und vergleichen Sie eine einfache Basislinie. Modellparameter, gegebenenfalls zufälliger Saatgut und Softwareversionen vorbehalten. Testen Sie realistische fehlende Daten und schwierige Bildbedingungen. Ein Ausbildungsablauf, der zusammenläuft oder abgeschlossen ist, ist nur ein technischer Schritt; seine Leistung muss noch gegen unabhängige Beweise und die Folgen der beabsichtigten Entscheidung bewertet werden.
Testen Sie einen repräsentativen Piloten
Ein Pilot für zufällige Landbedeckung Vorhersagen sollte den tatsächlichen Empfang Workflow ansprechen. Beginnen Sie mit einem repräsentativen Piloten, der die gewöhnlichen Bedingungen und schwierige Ausnahmen enthält. Fügen Sie relevante Grenzen, Mischflächen, fehlende Beobachtungen und bekannte Referenzstellen ein. Speichern Sie neben Quellmetadaten einige manuell geprüfte numerische Beispiele. Vergleichen Sie das Ergebnis mit einem unabhängigen Lesegerät oder einer Berechnung, wo praktisch. Der Pilot sollte den vollständigen Pfad aus der Quellauswahl durch Export testen, da eine richtige Formel noch durch falsche Einheiten, Bandauftrag oder Gültigkeitshandling untergraben werden kann. Wenn der Pilot verstanden wird, behalten Sie ihn als Referenz für spätere Revisionen.
Erkennen topspezifischer Interpretationsrisiken
Benachbarte Pixel desselben Feldes können nahezu identische Bedingungen in Trainings- und Auswertungsdaten einbringen und so zu Datenleckage führen. Die Merkmalswichtigkeit kann bei korrelierten Prädiktoren irreführend sein. Eine hohe Gesamtgenauigkeit kann schlechte Ergebnisse für eine seltene Klasse verdecken.
Die Überprüfung der zufälligen Landbedeckung Vorhersagen sollte nach der Berechnung abgeschlossen weitergehen. Assess mehr als eine Gesamtnote. Melden Sie klassenspezifische Verwirrung für die Klassifizierung oder Voreingenommenheit und Fehlermuster für Regression, mit Probenunterstützung und geographischem oder zeitlichem Umfang. Bewerten Sie schwierige und seltene Ziele bewusst. Halten Sie Modellergebnisse von kalibrierten Wahrscheinlichkeiten deutlich und erhalten Sie gegebenenfalls eine nicht unterstützte Domäne-Flagge. Überprüfen Sie repräsentative Fehler und vergleichen Sie die operative Überprüfung Belastung durch falsche Alarme. Bei der Übertragung oder Aktualisierung eines Modells bewerten Sie den Kandidaten auf unangetastete Daten und behalten die vorherige Version. Die Überwachung bleibt nur bei der Überprüfung von Eingaben und Ergebnissen zuverlässig, anstatt die erste Leistung zu übernehmen, bleibt unbestimmt.
Arbeiten durch ein Beispiel
In einer illustrativen Erntekarte platziert das zufällige Pixel-Splitting Teile jedes Feldes in beiden Sätzen. Die gesamte Felder zu halten, bietet einen härteren und relevanteren Test der Bereitstellung auf ungesehene Farmen.
Das Argumentationsbeispiel für zufällig-forest Landbedeckung Vorhersagen hat eine bewusst begrenzte Rolle. Das Beispiel in diesem Artikel ist illustrativ und ist kein gemeldetes Projektergebnis, Genauigkeitsanspruch oder Leistungsgarantie. Ersetzen Sie ihre Annahmen mit gemessenen Projektwerten, bevor Sie die Argumentation betriebsbereit verwenden. Halte Einheiten, Beobachtungsdaten und den entsprechenden Nenner sichtbar. Wenn eine vernünftige alternative Maske, Referenz oder Parameter die Entscheidung ändert, melden Sie diese Empfindlichkeit und erhalten bessere Beweise, wenn praktisch. Extra dezimale Stellen lösen keine Unsicherheit in dem, was beobachtet wurde. Behalten Sie ungelöste Fälle explizit statt den Parameter, der die überzeugendste Erzählung erzeugt, auszuwählen.
Bewertung gegen unabhängige Beweise
Melden Sie eine Verwirrungsmatrix, Klassenmetriken und räumlich unabhängige Leistung. Testtransfer über Termine, in denen der Einsatz erforderlich ist. Inklusive realistischen fehlenden Datenbedingungen.
Eine unabhängige Bewertung sollte die Grundgesamtheit und die Bedingungen repräsentieren, unter denen das Ergebnis eingesetzt wird. Trennen Sie Beobachtungen zur Parameterwahl oder zum Modelltraining von denen zur Leistungsbewertung. Berücksichtigen Sie schwierige Nichtziel-Fälle ebenso wie offensichtliche Ziele und bewahren Sie Informationen über fehlende oder nicht beobachtbare Gebiete. Stimmen Sie Zeitpunkt und räumliche Bezugsfläche der Referenz möglichst gut ab. Untersuchen Sie bei Abweichungen sowohl die Analyse als auch die Referenzbelege. Auch Referenzmessungen können unsicher sein; sie an die Karte anzupassen, ist keine gültige Korrekturstrategie.
Ungewissheit im nützlichen Maßstab melden
Bei zufälligen Landbedeckung Vorhersagen muss das Ergebnis seinen nachgewiesenen Umfang behalten. Überprüfung der Unsicherheit im Rahmen der beabsichtigten Entscheidung. Pixelabstand, effektive Sensorunterstützung, Bearbeitungsviertel und Managementeinheiten können sich erheblich unterscheiden. Viele resampled Pixel erstellen nicht viele unabhängige Beobachtungen. Für eine Flächenzusammenführung behalten Sie die gültige Deckung und Ausschlüsse; für ein Kandidatenmerkmal bewahren Sie das Erkennungsvertrauen und das Quelldatum auf. Separate systematische Effekte aus der lokalen Variation, wo die Nachweise erlaubt. Ein kleiner durchschnittlicher Fehler schließt keine Folgevorspannung in einer seltenen Klasse, einem bestimmten Material oder einem unterrepräsentierten Bereich aus. Die Bewertungsmethode ist in der Regel nicht enthalten.
Liefern Sie nutzbare GIS und Analysenachweise
Liefern Klassendefinitionen, Modellidentität, Prädiktor manifestieren und Bewertungsnachweise. ITSensing maschinelles Lernen Workflow kann mit diesen Steuerungen vor der wiederkehrenden Landbedeckung Produktion ausgewertet werden.
Die Übergabe an zufällige, Landbedeckung Vorhersagen sollte außerhalb der Autorenumgebung verständlich bleiben. Erbringen Sie einen zugänglichen Überblick zusammen mit den relevanten Geospatialdaten und einem präzisen Datenwörterbuch. Behalten Sie stabile Kennungen, Quellenangaben, Beobachtungsdaten, Verarbeitungsversion, Koordinatenreferenz und Qualitätsfelder. Erklären Sie unbekannte Bereiche und die nächste nützliche Überprüfung in einem Ausnahmeregister. Bitten Sie den empfangenden Analytiker, einen Musterpunkt zu finden, seine Beweise zu identifizieren und seine Einschränkungen zu interpretieren. Diese praktische Überprüfung kann fehlenden Kontext erkennen, dass eine Datei-Integritätsprüfung nicht erkennen kann. Bewahren Sie den Grund für Revisionen, damit eine spätere Änderung auf neue Beobachtungen oder eine geänderte Methode zurückverfolgt werden kann.
Bewertung der ITSensing Workflow mit realen Eingängen
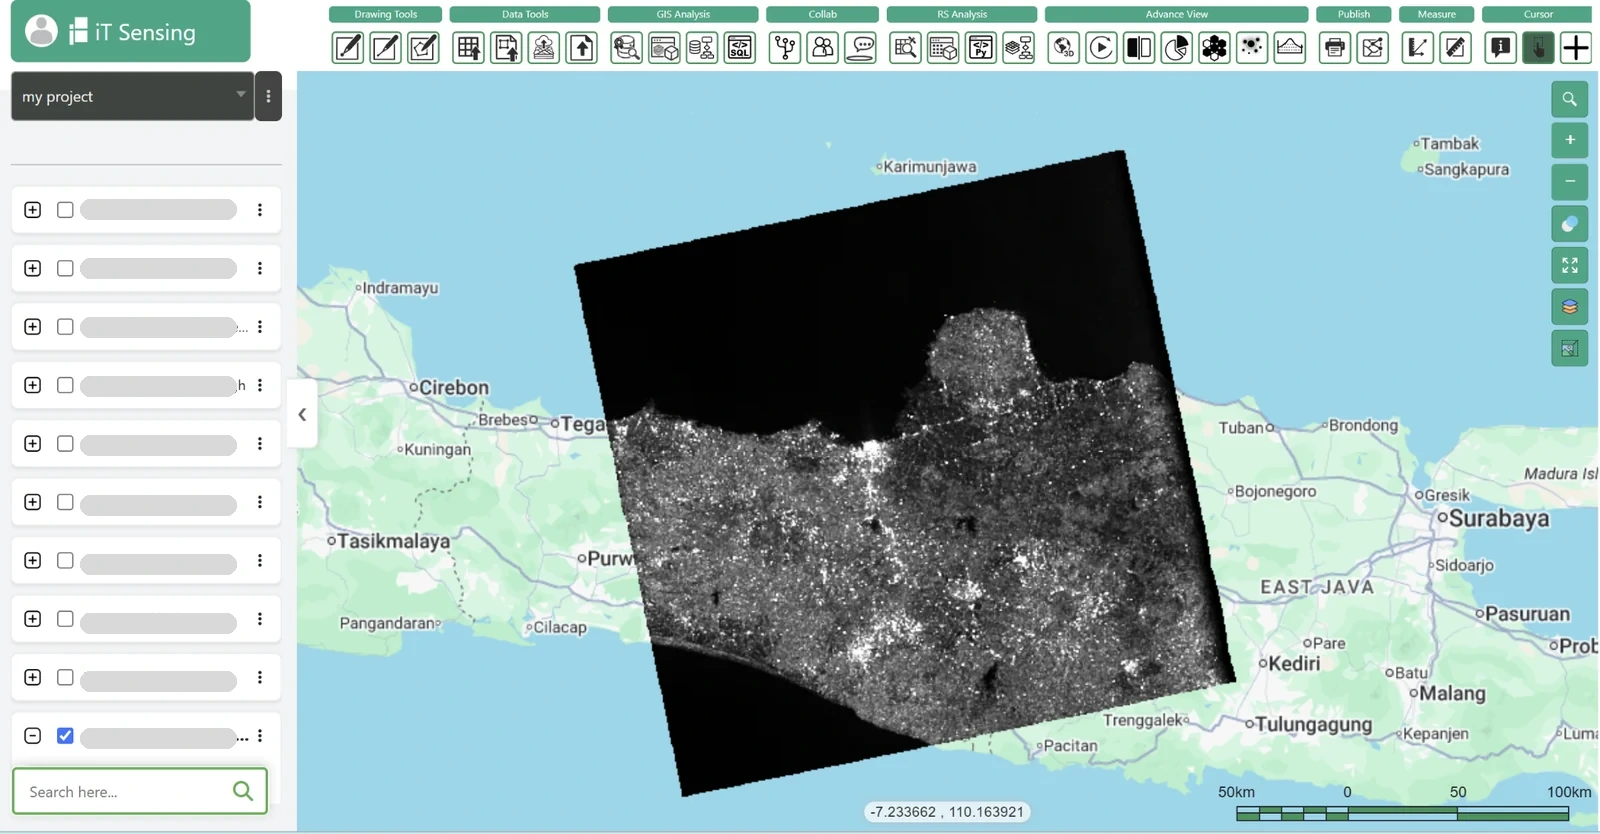
Bei der Bewertung von Cloud Fernerkundung Software für zufällige Forest Landbedeckung Vorhersagen verwenden Sie einen dokumentierten Piloten. Verwenden Sie den Produktvergleich, um eine komplette Workflow mit repräsentativen Daten zu testen. ITSensing präsentiert einen Cloud-Workspace für die Satelliten-Entdeckung, Raster und Spektralanalyse, maschinelles Lernen, GeoAI, Modellbau und Python-basierte Arbeit. Diese breiten Fähigkeiten stellen nicht fest, dass jede hier beschriebene spezialisierte Methode eine native Schaltfläche ist oder dass jeder externe Dienst direkt verbindet. Überprüfen Sie das tatsächlich dokumentierte Werkzeug, unterstützte Eingabe- und Exportpfad. Erhalten Sie Pilotnachweise und unabhängige Validierung, bevor Sie eine wiederkehrende Workflow wählen. Eine Produktlink ist ein Einstiegspunkt für die Auswertung, während die wissenschaftliche Interpretation an die Daten und Methode gebunden bleibt.