Definir la observación y decisión
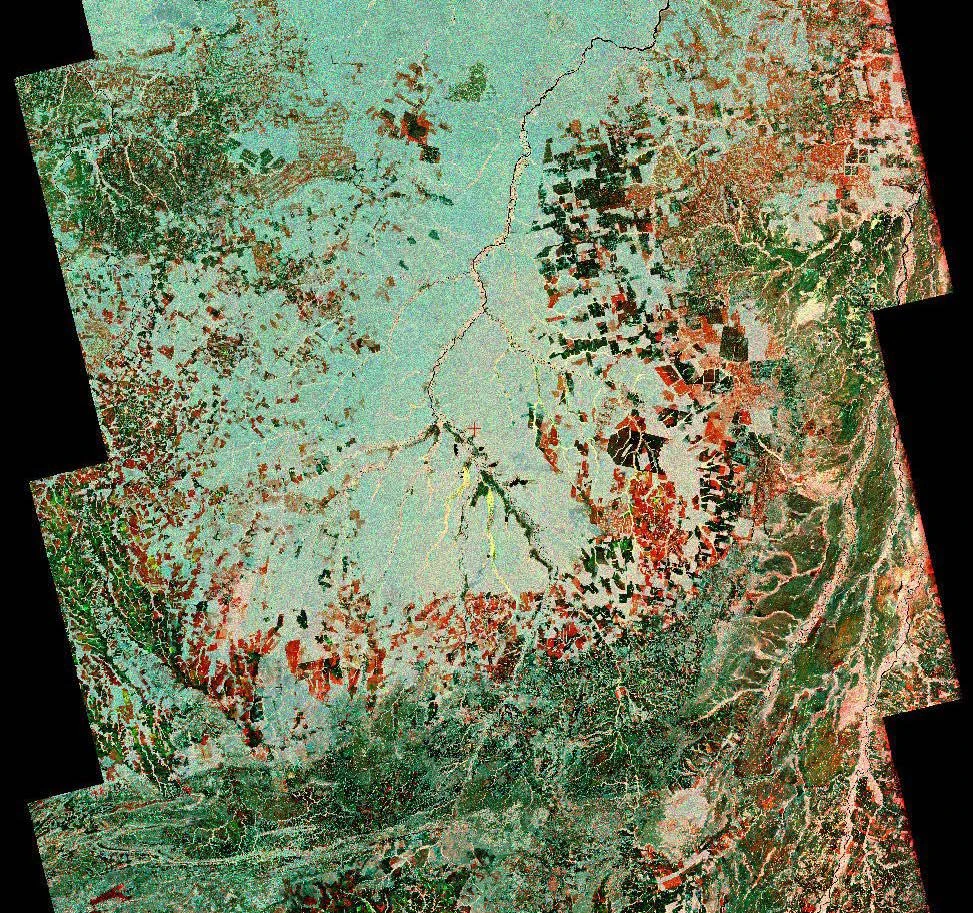
Un bosque aleatorio combina los árboles de decisión que se han instalado en ejemplos de capacitación. Puede modelar relaciones no lineales entre las características de satélite, pero sus predicciones reflejan las etiquetas y las condiciones de muestra. Un clasificador flexible no se generaliza automáticamente a otra región.
Para las predicciones de la selva aleatoria cobertura del suelo, comience con una pregunta precisa. Dirige la decisión y la cantidad antes de comparar los ajustes de software. Identificar quién utilizará el resultado, las unidades geográficas que reconocen y qué evidencia cambiaría una inspección o análisis. Escribe la condición de destino y explicaciones alternativas plausibles. Esto permite juzgar si la observación real del método puede responder a la pregunta. Un mapa de aspecto fino no es suficiente cuando la salida representa un proxy con un significado diferente. Retener un registro de hipótesis cortas para que los revisores posteriores puedan distinguir los insumos medidos, las opciones modelo y la interpretación.
Combinar el soporte de datos con el método
La base de medición para las predicciones de la selva aleatoria cobertura del suelo importa a lo largo de la interpretación. Un modelo de satélite aprende una relación entre los insumos definidos y los objetivos de referencia en condiciones de muestreo. No crea información ausente del sensor o correctos etiquetas inconsistentes automáticamente. Definir significados de clase o unidades de destino continuas antes de seleccionar un algoritmo. Coincide con la referencia de entrenamiento al tiempo de imagen y soporte espacial, y registra incertidumbre o desacuerdo en las etiquetas. Identificar la región de despliegue prevista, las condiciones de temporada y adquisición. Estas opciones determinan qué generalización debe ser probada e impiden que una puntuación de desarrollo impresionante se equivoque para demostrar que el modelo está listo para un entorno operativo diferente.
Preparar un análisis rastreable
Definir las clases, preparar predictores coherentes y separar la capacitación de evaluación geográficamente. Afinar mediante particiones de entrenamiento y comparar una base simple. Retener la semilla al azar, las definiciones de características y los parámetros modelo para la reproducibilidad.
La preparación para predicciones de la selva aleatoria cobertura del suelo debe preservar las siguientes pruebas. Preparar un manifiesto predictor reproducible con fechas de origen, orden de banda, unidades, máscaras y preprocesamiento. Evaluación separada antes de la selección de características, escalado, sintonización o extracción de parches puede filtrar información a través de la división. Use particiones geográficas o temporales apropiadas para el despliegue, y compare una simple base de referencia. Parámetros de modelo preservar, semillas aleatorias cuando sean aplicables y versiones de software. Prueba las condiciones realistas de datos y difícil imagen. Una carrera de capacitación que converge o completa es sólo un paso técnico; su producción debe ser evaluada aún contra pruebas independientes y las consecuencias de la decisión prevista.
Prueba a un piloto representativo
Un piloto para predicciones de la selva aleatoria cobertura del suelo debe abordar el actual receptor flujo de trabajo. Comience con un piloto representativo que contenga condiciones ordinarias y excepciones difíciles. Incluir los límites pertinentes, superficies mixtas, observaciones faltantes y lugares de referencia conocidos. Guardar algunos ejemplos numéricos revisados manualmente junto con metadatos de origen. Compare el resultado con un lector independiente o cálculo donde sea práctico. El piloto debe probar el camino completo de la selección de fuentes a través de la exportación, ya que una fórmula correcta puede ser socavada por unidades equivocadas, orden de banda o manejo de validez. Una vez que el piloto se entienda, retenga como referencia para revisiones posteriores.
Reconocer los riesgos de interpretación específicos para cada tema
Los píxeles cercanos de la misma parcela pueden introducir condiciones casi idénticas en los conjuntos de entrenamiento y evaluación, causando fuga de información. La importancia de las variables puede ser engañosa cuando los predictores están correlacionados. Una exactitud global alta puede ocultar un mal rendimiento en una clase poco frecuente.
El examen de las predicciones de la selva aleatoria cobertura del suelo debe continuar después de que el cálculo termine. Evalua más de una puntuación general. Informe confusión específica de clase para clasificar o sesgo y patrones de error para la regresión, con soporte de muestra y alcance geográfico o temporal. Evaluar objetivos difíciles y raros deliberadamente. Mantenga las puntuaciones modelo distintas de las probabilidades calibradas y mantenga una bandera de dominio sin soporte cuando sea apropiado. Inspeccione errores representativos y compare la carga de revisión operacional creada por falsas alarmas. Al transferir o actualizar un modelo, evalúe al candidato sobre datos no utilizados y mantenga la versión anterior. La vigilancia sigue siendo fiable sólo cuando se examinan los insumos y los resultados cambiantes, en lugar de asumir que el desempeño inicial persiste indefinidamente.
Trabajar a través de un ejemplo ilustrativo
En un mapa ilustrativo de cultivos, el píxel aleatorio divide partes de cada campo en ambos conjuntos. Mantener campos enteros proporciona una prueba más dura y más relevante de despliegue a granjas invisibles.
El ejemplo de razonamiento para las predicciones de la selva aleatoria cobertura del suelo tiene un papel deliberadamente limitado. El ejemplo de este artículo es ilustrativo y no es un resultado de proyecto reportado, una garantía de exactitud o rendimiento. Sustitúyase sus hipótesis con valores de proyecto medidos antes de utilizar el razonamiento operacionalmente. Mantenga las unidades, fechas de observación y el denominador relevante visible. Si una máscara alternativa razonable, referencia o parámetro cambia la decisión, informe que la sensibilidad y obtenga mejores pruebas cuando sea práctico. Los lugares decimales adicionales no resuelven la incertidumbre en lo que se observó. Retener casos no resueltos explícitamente en lugar de seleccionar el parámetro que produce la narrativa más persuasiva.
Evaluar la situación frente a pruebas independientes
Informe una matriz de confusión, métricas de clase y rendimiento espacialmente independiente. Transferencia de pruebas en fechas en las que el uso operativo lo requiere. Incluir condiciones realistas de datos perdidos.
La evaluación independiente debe representar la población y las condiciones en que se utilizará el resultado. Separe las observaciones empleadas para elegir parámetros o entrenar el modelo de las destinadas a evaluar su rendimiento. Incluya casos difíciles que no sean el objetivo, además de objetivos evidentes, y conserve información sobre áreas sin datos o no observables. Ajuste lo mejor posible el momento y el soporte espacial de la referencia. Ante una discrepancia, investigue tanto el análisis como la evidencia de referencia. Esta también puede tener incertidumbre; forzarla a coincidir con el mapa no es una corrección válida.
Informar la incertidumbre a la escala útil
Para las predicciones de la selva aleatoria cobertura del suelo, el resultado debe conservar su alcance demostrado. Revisar la incertidumbre a la escala de la decisión prevista. El espaciamiento de píxel, el soporte eficaz de sensores, los barrios procesados y las unidades de gestión pueden diferir sustancialmente. Muchos píxeles remuevados no crean muchas observaciones independientes. Para un resumen de área, preservar cobertura válida y exclusiones; para una función de candidato, preservar la confianza de detección y fecha de origen. Efectos sistemáticos separados de la variación local donde las pruebas permiten. Un pequeño error promedio no descarta un sesgo consiguiente en una clase rara, un material particular o una región infrarrepresentada. Informe el alcance demostrado por la evaluación.
Entregar evidencia usable GIS y análisis
Entregar definiciones de clase, identidad modelo, evidencia de manifiesto predictor y evaluación. ITSensing aprendizaje automático flujo de trabajo se pueden evaluar con estos controles antes de la producción recurrente de cobertura del suelo.
La entrega para predicciones de la selva aleatoria cobertura del suelo debe seguir siendo comprensible fuera del entorno autor. Ofrecer una visión general accesible junto con los datos geoespaciales pertinentes y un diccionario de datos conciso. Retener identificadores estables, referencias de origen, fechas de observación, versión de procesamiento, campos de referencia y calidad. Explicar áreas desconocidas y el próximo cheque útil en un registro de excepción. Pida al analista receptor que busque un elemento de muestra, identifique sus pruebas e interprete sus limitaciones. Esa revisión práctica puede revelar el contexto perdido que un cheque de integridad de archivos no puede detectar. Preserve la razón de las revisiones para que un cambio posterior pueda ser rastreado a nuevas observaciones o un método cambiado.
Evaluar el ITSensing flujo de trabajo con entradas reales
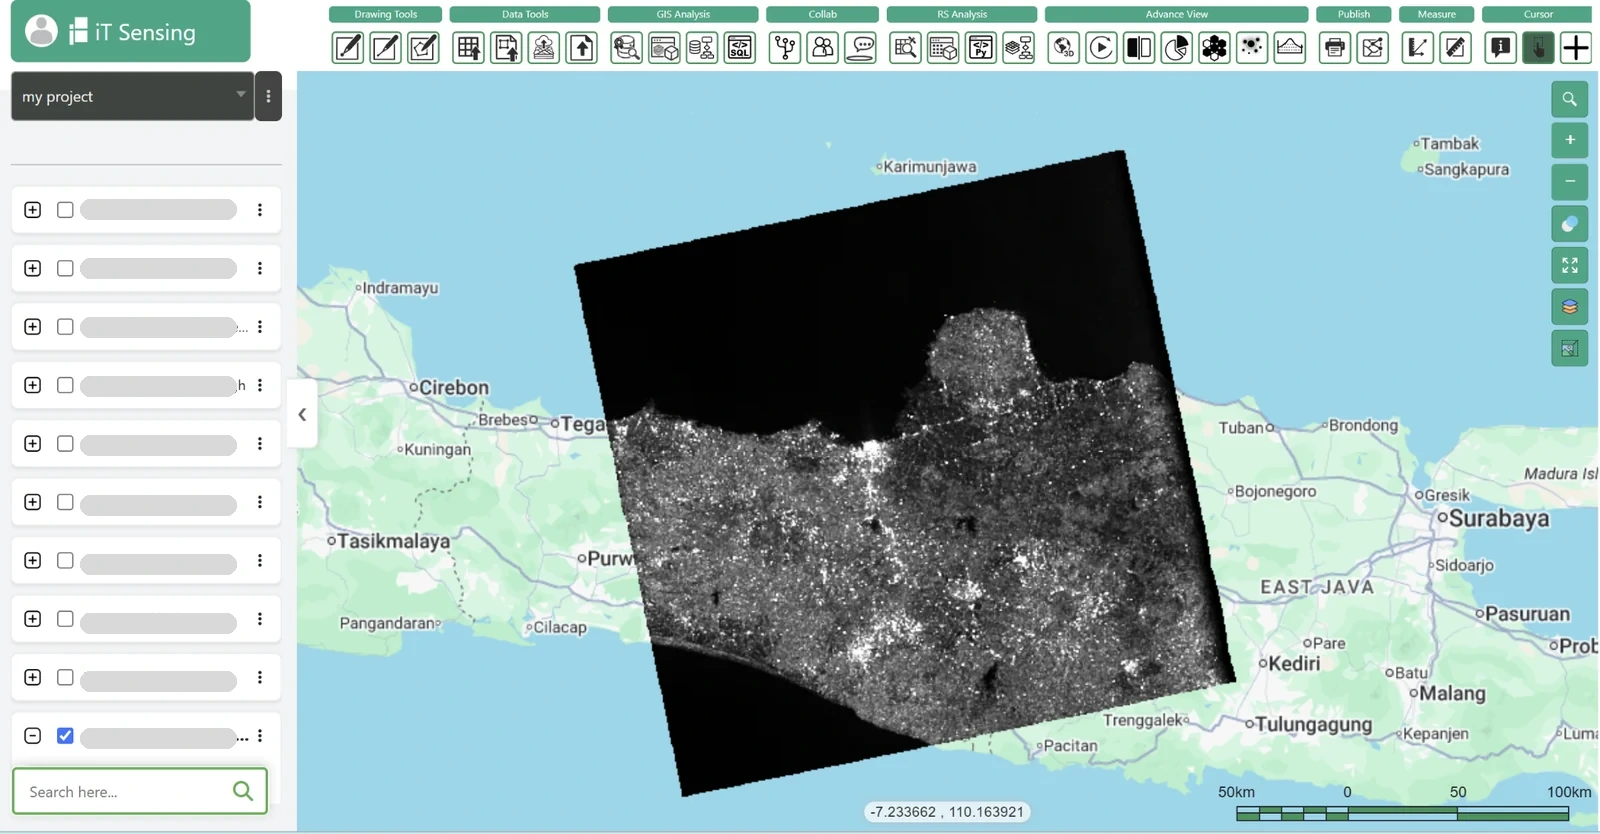
Al evaluar el software de nube teledetección para predicciones de la selva aleatoria cobertura del suelo, utilice un piloto documentado. Utilice la comparación de productos para probar un flujo de trabajo completo con datos representativos. ITSensing presenta un espacio de trabajo en la nube para el descubrimiento por satélite, el raster y el análisis espectral, aprendizaje automático, GeoAI, construcción de modelos y trabajo basado en Python. Esas amplias capacidades no establecen que cada método especializado descrito aquí es un botón nativo o que cada servicio externo se conecta directamente. Compruebe la herramienta documentada real, el acceso de entrada y la ruta de exportación compatibles. Retener pruebas piloto y validación independiente antes de elegir un flujo de trabajo recurrente. Un enlace de producto es un punto de entrada para la evaluación, mientras que la interpretación científica sigue vinculada a los datos y el método.